Europas fysikk- og livsvitenskapsmiljøer beveger seg inn i en ny æra av ekstrem skala-beregning: exascale-klassesystemer, trillion-parameter AI, datatørste instrumenter, og arbeidsflyter som blander simulering, analyse og AI i samme jobb. Her er den harde sannheten de fleste bare innrømmer etter en brutal første skalatest: nettverket er flaskehalsen, ikke GPU-ene, ikke lagring, ikke engang CPU-en.
Det er her Cornelis CN5000 Omni-Path® og Hammer’s HPC-løsningsdesign og -levering passer sammen: en fabric konstruert for å forbli forutsigbar under høy belastning, kombinert med en tilnærming som hjelper europeiske organisasjoner med å designe, validere, distribuere og støtte arkitekturen som matcher deres applikasjoner.
Hva har endret seg i europeisk forskningsdatabehandling, og hvorfor nettverksstrukturen betyr mer enn noen gang
Fysikk og livsvitenskap treffer begge lignende presspunkter:
- Storskala MPI-kollektiver (allreduce/alltoall), følsomme for haleforsinkelse
- Mange små meldinger der meldingshastighet betyr like mye som båndbredde
- Incast- og bursty trafikk (vanlig i AI-trening, rekonstruksjon og analytics-shuffles)
- Simulering med høy synkroniseringsavhengighet der jitter blir til bortkastet beregningstid
Når et sammenkoblingsnettverk blir overbelastet eller introduserer langhalede forsinkelser, ser du at utnyttelsen kollapser - dyre akseleratorer står uvirksomme og venter på neste batch eller kollektiv operasjon.
CN5000 i klartekst: hva det er, og hva det er designet for å fikse
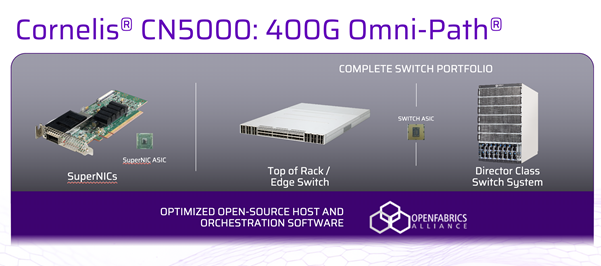
Cornelis CN5000 Omni-Path er en skalerbar nettverksplattform rettet mot AI- og HPC-miljøer der høy gjennomstrømming og stabil ytelse er nødvendig, selv når systemet er belastet.
Noen praktiske punkter som betyr noe for HPC-team:
- 400G per port svitsjing (CN5000-svitsjer refereres ofte til som 48-ports 400G-klasse, og leverer svært høy samlet båndbredde per svitsj)
- Svært høy pakkebehandlingskapasitet (kritisk for HPC-trafikk med små meldinger)
- Et designfokus på å unngå ytelsesfall gjennom tapsfri oppførsel, håndtering av fabric-overbelastning, multipath-ruting og robust flytkontroll
Kjerneideen: hold kommunikasjonen forutsigbar når klyngen er full av ekte jobber, ikke bare når man kjører idealiserte tester på et stille nettverk.
Hvor Hammer passer inn for å gjøre CN5000-kapasiteten til en distribuerbar europeisk løsning
CN5000 er fabric-teknologien. Hammers verdi er å få den til å fungere i den virkelige verden – ved å balansere ytelsesmål med innkjøpsbegrensninger, tidslinjer, stedsstandarder og operasjonell beredskap.
I praksis betyr det vanligvis:
- Oversette applikasjonsbehov (MPI, AI-trening, pipeline-analyser) til et skalerbart fabric-design
- -Validere ytelse med de riktige testene (ikke bare leverandørstandard-benchmarks
- Levere en integrert løsning:
- Svitsjing
- Kabling
- Vertstilkobling
- Konfigurasjon
- Utrullingsstøtte
- Hjelpe team med å operasjonalisere:
- Overvåking
- Endringskontroll
- Reservedelsstrategi
- Støttemønstre for dag to
Sammenligningstabell: CN5000 vs vanlige HPC/AI-interkonnekt-tilnærminger
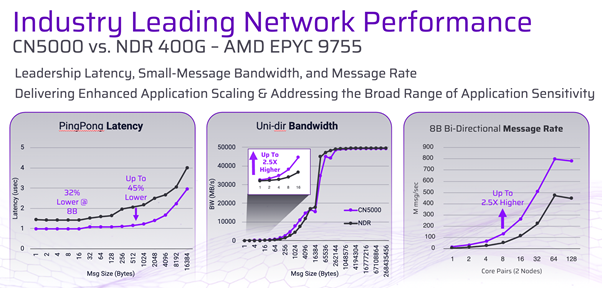
Den “beste” sammenkoblingen avhenger av arbeidsmengde, skala og operasjonelle preferanser. Tabellen nedenfor er en praktisk, arkitekturnivå-sammenligning du kan bruke i tidligfase-designsamtaler.
|
Kriterium |
Cornelis CN5000 Omni-Path |
InfiniBand (moderne generasjoner) |
Ethernet (RoCE / høyytelses-Ethernet) |
|
Primært designmål |
AI + HPC-skala-ut med forutsigbare fullføringstider under belastning |
HPC/AI-skalerbarhet, mye brukt i toppmoderne HPC |
Bredt datasenter + AI/HPC der standardtilpasning og felles verktøy er nøkkelen |
|
Batferd under overbelastning |
Bygget for å minimere overbelastningspåvirkning og holde ytelsen stabil (tapfri fabric-intensjon) |
Sterke alternativer avhengig av konfigurasjon og overbelastningskontroll |
Kan være utmerket, men har en tendens til å være mer følsom for riktig tuning (PFC/ECN, buffering, QoS) |
|
Hale-latensfølsomhet |
Generelt optimalisert for lav latens og meldingsrate |
Generelt veldig sterkt for lav latens og kollektiver |
Kan være konkurransedyktig, men tail-latens kan forringes hvis feilkonfigurert eller oversubscribed |
|
Operasjonell kompleksitet |
HPC-fokusert verktøy og modell; typisk mer “fabric-first” |
Modent økosystem; sterke operasjonelle mønstre i HPC |
Kjent for nettverksteam, men “HPC-grade RoCE” krever vanligvis nøye designdisiplin |
|
Økosystem og integrasjon |
Bygget for HPC/AI-stakker; integrasjon avhenger av plattformvalg |
Svært bred HPC-økosystemstøtte |
Bredeste leverandør-/verktøyøkosystem totalt sett |
|
Typisk optimalt område |
Tette kollektiver, meldingsrate-tung HPC, blandede AI/HPC-klynger der forutsigbarhet er prioriteten |
Svært store HPC/AI-distribusjoner med etablerte IB-praksiser |
Nettsteder som standardiserer på Ethernet, blandede arbeidsbelastninger, eller søker en enhetlig nettverksoperasjonsmodell |
|
Vanlig risiko hvis valgt dårlig |
Underdimensjonert validering (ikke testet reelle arbeidsbelastningsmønstre tidlig) |
Kostnads-/tilgjengelighetsplanlegging; designvalg betyr noe i stor skala |
“Det er Ethernet, det går bra”-tenkning, til PFC-stormer, QoS-hull eller støyende naboer dukker opp |
Hvis du vil ha en tommelfingerregel: HPC og vitenskapelig AI trenger ikke bare raske koblinger; de trenger et fabric som holder seg fornuftig når alle kommuniserer samtidig.
En praktisk blåkopi: utrulling av CN5000 for europeisk fysikk og biovitenskap
1) Start med kommunikasjonsprofilen (ikke portantall)
Still spørsmål som:
- Er vi kollektiv-dominert (allreduce/alltoall)?
- Er vi meldingsrate-bundet (mange små meldinger)?
- Ser vi ytelsesfall når systemet er opptatt?
- Venter GPU-er på synkronisering?
Dette avgjør om du bør optimalisere for båndbredde, latens, haletidsatferd eller en balansert tilnærming.
2) Design for skaleringsfaser, ikke et enkelt øyeblikksbilde
Mange europeiske organisasjoner skalerer i faser:
- Pod- eller rack-skala bevis på verdi
- Multi-rack produksjon
- Multi-klynge eller føderert vekst
Et CN5000-fabrikkdesign bør gjenspeile dette fra dag én, inkludert topologi, kablingsstrategi, vekstporter og operasjonelle grenser.
3) Valider med ekte vitenskap Ikke stopp ved mikrobenchmarks. Inkluder:
- MPI-kollektiver i tiltenkt skala
- Mini-apper og representative kjerner
- AI-treningskommunikasjonstester (kollektivtunge trinn)
- Belastningstester med flere leietakere hvis du kjører delt infrastruktur
Målet er å oppdage “stille lab-seire” kontra “produksjonsvirkelighets-seire” tidlig, mens endringer fortsatt er rimelige.4) Operasjonaliser tidlig (fordi dag-2 er hvor prosjekter lykkes eller dør)
Planlegg for:
- Telemetri og dashboards (latens, overbelastningssignaler, linkfeil, hotspots)
- Endringsstyring (fastvare, konfigurasjonsdrift, kontrollert utrulling)
- Reservedeler og robusthetsplanlegging
Det er her Hammers leverings- og støttetilnærming kan tette gapet mellom et raskt fabric og en håndterbar tjeneste.
Referansearkitekturmønstre for europeiske laboratorier og forskningsinstitutter
Her er tre vanlige mønstre som fungerer godt når man bygger rundt CN5000 for fysikk- og livsvitenskapsmiljøer
Mønster A: “Vitenskaps-pod” for rask adopsjon
- 1–2 rack med datakraft (CPU eller GPU)
- Dedikert CN5000 bladbytte
- Tydelige ingress/egress-grenser til lagring og det bredere campusnettverket
- Ideell for å bevise reelle arbeidsbelastningsgevinster og trene driftsteam
Mønster B: Blandet AI + HPC-produksjonsklynge
- Separate logiske partisjoner eller køer for:
- AI-trening
- Simulering
- Datapipelines
- Fabric designet for å unngå støyende nabo-påvirkninger under topp treningskjøringer
- Vekt på forutsigbare kollektiver og stabile jobb-fullføringstider
Mønster C: Vekst i flere klynger med delte tjenester
- Flere CN5000-baserte klynger (f.eks. bildebehandling for livsvitenskap, fysikksimulering)
- Delte tjenester:
- Autentisering
- Planleggingspolicy
- Overvåking
- Lagring
- Fabric-strategi fokuserer på repeterbarhet: “Vi kan distribuere dette igjen med trygghet.”
Det finnes ingen enkelt “riktig” design-- det er at du kan tilpasse topologien og driftsmodellen til hvordan organisasjonen din faktisk fungerer.
Datastyring, sikkerhet og samarbeid på tvers av Europa
Fysikk og biovitenskap befinner seg ofte i hver sin ende av datastyringsspekteret – fra relativt åpne eksperimentelle data i enkelte fysikkdomener, til svært sensitive persondata i deler av biovitenskapen. Moderne HPC-nettverksdesign må anerkjenne denne realiteten.
Når du distribuerer CN5000-basert infrastruktur i europeiske miljøer, er det viktig å bygge inn
- Segmentering etter design (prosjekter, leietakere, regulerte datasett)
- Revisbar endringskontroll (hvem endret hva, når og hvorfor)
- Tydelige grenser til lagring og eksterne nettverk (minimer uventede datastier)
- Samarbeidsberedskap (støtte for fødererte tilgangsmodeller, der det er hensiktsmessig
Ingenting av dette er prangende, men det er ofte forskjellen mellom “en rask klynge” og “en plattform organisasjonen kan stole på i de neste fem årene”.
Vanlige bruksområder der CN5000 + Hammer-leveranse kan utgjøre en forskjell
AI-trening for vitenskapelige modeller
- Kollektiver, synkroniseringspunkter og burst-mønstre dominerer
- Forutsigbarhet under belastning er det som forbedrer tid-til-resultater
Storskala simulering med synkroniseringspunkter
- Hale-latens og jitter kan alvorlig påvirke tett koblet fysikksimulering
- Meldingsrate-kapasitet og stabil oppførsel betyr noe
Avbildning, rekonstruksjon og multi-omics-rørledninger
- Workflows mix bandwidth-heavy stages and communication-heavy shuffles
- Kjøres ofte samtidig på tvers av flere team
FAQ: Hvordan CN5000 Omni-Path hjelper i ekte HPC + AI-klynger
How does Cornelis CN5000 Omni-Path improve HPC and AI performance in real clusters?
I produksjonsklynger er gjennomstrømming ofte ikke begrensningen, det er overbelastning og langhale-latens. CN5000 er bygget for å holde kommunikasjonen forutsigbar under belastning, slik at jobber ikke treffer «ytelsesklipper» når mange leietakere eller mange ranger kommuniserer samtidig.
Praktisk sett kommer dette fra et Omni-Path-design som legger vekt på:
- Tapsfri oppførsel med kredittbasert flytkontroll (så du ikke faller inn i tap/retransmit-spiraler under press).
- Finkornet adaptiv ruting / multipath for å styre rundt forbigående hotspots.
- Aktiv overbelastningshåndtering (ofte beskrevet som svitsj-informert pacing/nedbremsing) for å redusere haleeffekter.
Nettoeffekten: færre stopp i kollektiver og synkroniseringsfaser, og bedre akseleratorutnyttelse når fabricen er opptatt.
Hvilke typer arbeidsbelastninger har størst nytte av CN5000 i fysikk og livsvitenskap?
CN5000 har en tendens til å vise seg best når jitter og halelatens dominerer resultatene, spesielt:
- Tette MPI-kollektiver (f.eks. allreduce/alltoall) i stor skala
- Applikasjoner med høy meldingsrate og mange små meldinger
- Synkroniseringstunge simuleringer der noen få trege ranger drar ned tidssteget
- Bursty eller incast-tung trafikk sett i multi-node AI-trening, rekonstruksjonspipeliner og shuffle-tung analyse
Hvis profilen din viser økende tid brukt på kollektiver, barrierer eller halo-utvekslinger når du skalerer ut, er dette den typen problem CN5000 er designet for å løse.
Hvorfor blir nettverket flaskehalsen før GPU-er eller lagring i stor skala?
As clusters scale, more wall time is spent coordinating (gradients, reductions, exchanges, barriers. When congestion or long-tail delays appear, the fastest nodes and GPUs end up waiting for the slowest communication events. Utilization can collapse even if “peak bandwidth” looks strong paper.
Hvordan skiller CN5000 seg fra InfiniBand eller høyytelses Ethernet (RoCE)?
På et høyt nivå:
- CN5000 (Omni-Path): Posisjonert som en ende-til-ende skalerbar fabric optimalisert for forutsigbar ytelse under belastning, med tapsfri oppførsel, adaptiv ruting og overbelastningskontroll som førsteklasses designmål.
- InfiniBand: mye utplassert i topp-HPC med et dypt økosystem og modne operasjonelle praksiser (utmerket ytelse, bred leverandørstøtte).
- RoCE / høyytelses Ethernet: Operativt kjent og i stand til sterk ytelse, men krever vanligvis disiplin rundt PFC/ECN-design, buffering, QoS og kontroll av støyende naboer for å unngå overraskelser med hale-latens i stor skala.
Det er også verdt å si det rett ut: CN5000’s “fulle fordeler” beskrives typisk som å komme fra en ende-til-ende Omni-Path-løsning (svitsjer + NIC-er) snarere enn å mikse og matche i databanen.
Hva leverer Hammer faktisk i et CN5000-basert HPC-prosjekt?
Hammer turns the interconnect into something you can run day to day, typically covering:
- Requirements → fabric design: (topology, oversubscription targets, growth plan, cabling strategy)
- Validering: testplaner som gjenspeiler reelle arbeidsbelastninger (ikke bare stille laboratorie-mikrobenchmarks)
- Bygging og utrulling: svitsjer, optikk/kabler, vertstilkobling, konfigurasjonsmaler, støtte for overgang
- Operasjoner: forventninger til overvåking/telemetri, endringskontroll, reservedelsstrategi og støtterunbooks
Hvordan bør vi validere et CN5000-nettverk før vi forplikter oss til full utrulling?
En praktisk validering før utrulling inkluderer vanligvis:
- MPI kollektive tester i tiltenkt skala (ikke bare enkeltrack)
- Mini-apper / representative kjerner fra din faktiske brukerbase
- AI-kommunikasjonstester som belaster kollektivtunge trinn (og overlappende mønstre)
- Stresstester med blandede leietakere for å avdekke støyende nabo-effekter og langhale-oppførsel
Målet: fange tilfeller der “stille lab-seire” ikke oversettes til produksjon—mens topologi- og policy-endringer fortsatt er billige.
Hvordan designer vi et CN5000-nettverk for faset vekst på tvers av europeiske forskningssteder?
Mange programmer skalerer i faser (pod → multi-rack → multi-cluster/federation). Vanlige designvalg som holder veksten smertefri:
- Velg en topologi med en klar utvidelsesvei (porter reservert for vekst, forutsigbar kabling)
- Definer operasjonelle grenser tidlig (leietakere/partisjoner/køer, QoS-forventninger)
- Planlegg hvordan du’ll håndterer endringskontroll og “blast radius” når du legger til rack eller nettsteder
På den måten introduserer ikke skalering utilsiktet nye flaskehalser eller støyende nabo-atferd
Hvordan kan CN5000-distribusjoner støtte datastyring og sikkerhet i hele Europa?
I regulerte life science-miljøer er nettverket en del av kontrollplanet for styring. Typiske mønstre inkluderer:
- Segmentering etter prosjekt/leietaker (så regulerte datasett ikke deler overraskelsesstier)
- Revisbar konfigurasjon + endringskontroll tilpasset din sikkerhetsmodell
- Tydelige grenser til lagring og eksterne nettverk for å unngå utilsiktede datautgangsruter
- Der samarbeid er nødvendig, bevisste fødererte tilgangsmønstre i stedet for ad-hoc peering
Viktige takeaways for europeiske forskningsledere
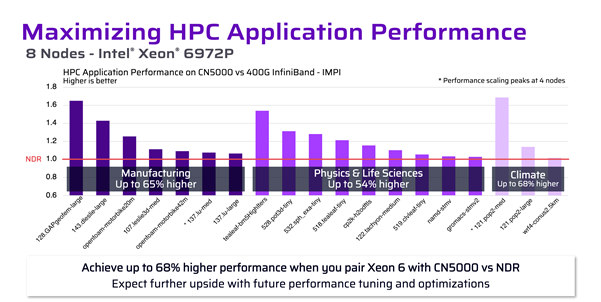
- Nettverket er i økende grad den avgjørende faktoren for reell ytelse i fysikk og livsvitenskap, spesielt med blandede AI + HPC-arbeidsbelastninger.
- Cornelis CN5000 er rettet mot forutsigbar ytelse i stor skala, der overbelastningsatferd og halelatens ofte dominerer jobbens fullføringstid.
- Hammer hjelper med å oversette den kapasiteten til en fungerende europeisk løsning:
- Designet
- Validert
- Distribuert
Opererbart som en tjeneste– ikke bare en samling av høytytende komponenter. Kontakt ekspertene våre i dag for å diskutere Cornelis Networks Solutions
Vil du vite mer?